Verbinden Sie die generative Kraft moderner Sprachmodelle mit der Faktenbasis Ihres eigenen Unternehmens. Retrieval-Augmented Generation (RAG) reichert Prompts zur Laufzeit mit verifizierten Daten an – für höchste Faktentreue ohne externes Vortraining.
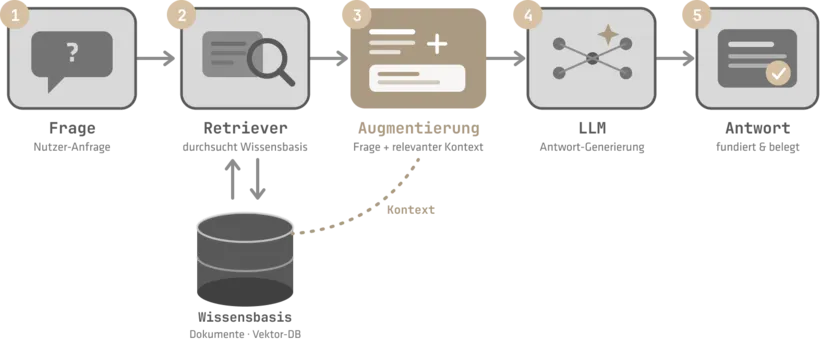
5-stufiger RAG-Prozess
Die Pipeline im Detail: So funktioniert RAG
Daten-Embedding & Architektur-Autonomie
Die Kernkomponenten für Enterprise-Stabilität
Warum RAG der Enterprise-Standard ist
Ihre Vorteile auf einen Blick
Technische FAQs zur RAG-Infrastruktur
Ein hochwertiges Daten-Embedding basiert auf einer präzisen Vorverarbeitung (Data Cleansing) und einer strukturierten Zerlegung (Chunking) der Rohdaten. Unter Berücksichtigung des spezifischen Fachwissens über Ihre Datenstrukturen werden relevante Metadaten (z. B. Erstellungsdatum, Dokumententyp, Quellsystem) direkt in die Vektoren injiziert. Das sorgt dafür, dass der Retriever semantisch hochrelevante Kontexte liefert und das Rauschen bei der Abfrage minimiert wird.
Der Rechenaufwand bei RAG ist um ein Vielfaches geringer. Da das Sprachmodell selbst (Schritt 4) nicht neu trainiert oder modifiziert werden muss, entfallen die massiven GPU-Kosten für Trainingszyklen. Die Pipeline nutzt die Standard-Inferenz des Modells und reichert diese lediglich zur Laufzeit mit Kontext an. Der zusätzliche Rechenaufwand beschränkt sich auf die performante Vektorsuche in der Wissensbasis, die sich im Millisekundenbereich bewegt.
Vollständig flexibel. Da die Wissensbasis (Vektor-DB) und der Ingestion-Prozess logisch und physisch vom generativen Sprachmodell entkoppelt sind, bleibt Ihre Daten-Infrastruktur bei einem Modellwechsel unberührt. Sobald ein leistungsstärkeres oder kosteneffizienteres KI-Modell (z. B. eine neue Iteration von DeepSeek oder Qwen) verfügbar ist, muss lediglich die API-Schnittstelle im Inferenz-Layer angepasst werden. Ein erneutes Einlesen oder Transformieren Ihrer Unternehmensdaten ist nicht erforderlich.
Die Aktualisierung erfolgt über automatisierte Event-Pipelines. Sobald in Ihren angeschlossenen Systemen (z. B. CRM, ERP oder Pimcore) Daten geändert, gelöscht oder hinzugefügt werden, triggert das System einen Webhook. Das betroffene Dokument wird isoliert neu partitioniert, in Vektoren übersetzt und in der Vektor-DB aktualisiert. Dadurch greift der Retriever bei der nächsten Benutzeranfrage ohne spürbare Verzögerung auf den neuesten Datenstand zu.
Durch das Prinzip der Augmentierung (Schritt 3) wechselt die Rolle des Sprachmodells von einer unzuverlässigen Wissensquelle zu einer reinen Verarbeitungseinheit. Dem Prompt wird die explizite System-Instruktion mitgegeben, die Antwort ausschließlich auf Basis des mitgelieferten Kontexts zu generieren. Besitzt das Modell keine passenden Fakten aus der Wissensbasis, verweigert es die Aussage, anstatt plausible, aber falsche Fakten zu erfinden.
Ja. Da das Gesamtsystem lokal oder in dedizierten EU-Rechenzentren betrieben werden kann, verbleiben alle sensible Unternehmensdaten innerhalb Ihrer definierten Sicherheitsgrenzen. Der gesamte RAG-Prozess läuft vollständig gekapselt ab. Da kein externes Training stattfindet, besteht kein Risiko, dass vertrauliche Informationen in die globalen Wissensdatenbanken öffentlicher KI-Anbieter einfließen.
Kontakt
- Schnelle Antwort
- Persönliches Feedback statt Standardmails
- Klare, offene Kommunikation
Beschreiben Sie uns kurz, wobei wir helfen können.
Wir freuen uns auf Ihre Nachricht!