Enterprise KI-Architektur. Modularer 4-Schichten-Stack für maximale Performance.
Von der dedizierten GPU-Hardware bis zum Applikations-Layer. Die Infrastruktur von noucore trennt Compute, Datenhaltung und Orchestrierung strikt voneinander – für maximale Skalierbarkeit, niedrige Latenzen und vollständige digitale Souveränität.
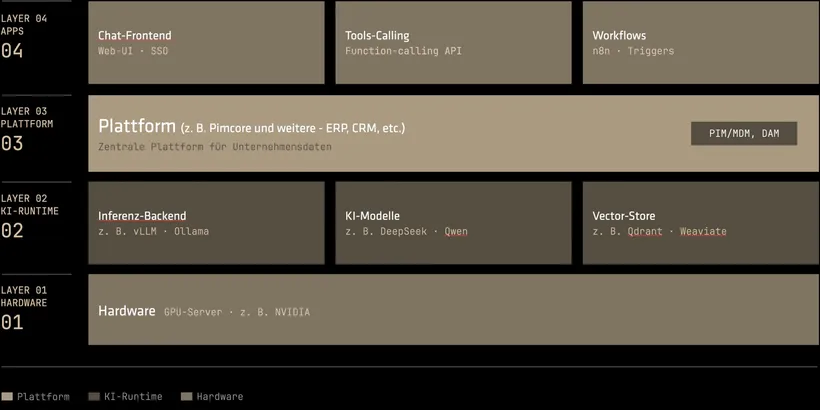
Die Architektur-Schichten im Detail
Architektur-Richtlinien für Enterprise-Anforderungen
Flexible Deployment-Modelle: Maximale Souveränität für Ihre Infrastruktur
Wählen Sie das Betriebsmodell, das perfekt zu Ihren Compliance-, Sicherheits- und Performance-Anforderungen passt. Unser 4-Schichten-Stack unterstützt sowohl voll isolierte On-Premise-Umgebungen als auch hochverfügbare Cloud-Infrastrukturen.
FAQs zur Hardware und Bereitstellung
Die Architektur von noucore basiert auf einem modularen 4-Schichten-Stack. Dieser trennt Compute (Hardware), Inferenz (Runtime), Datenverwaltung (Plattform) und Anwendung (Apps) strikt voneinander. Diese klare Trennung ermöglicht maximale Skalierbarkeit, minimale Latenzen und vollständige digitale Souveränität.
Die technologische Basis bildet eine dedizierte GPU-Server-Infrastruktur. Da auf Shared-Environment-Modelle verzichtet wird, stehen der gesamte VRAM sowie die Tensor-Compute-Power exklusiv für Ihre Workloads zur Verfügung, was Latenz-Spitzen bei parallelen Zugriffen verhindert.
Die Runtime-Schicht nutzt modernste Open-Source-Frameworks mit fortgeschrittenen Optimierungstechniken wie PagedAttention und Continuous Batching. Diese Techniken minimieren den Speicherbedarf und maximieren gleichzeitig den parallelen Request-Durchsatz der Engines.
Nein, die Architektur ist vollständig modell-agnostisch konzipiert. Sie erlaubt das native Deployment führender Open-Source-LLMs, die exakt für Ihre spezifische Business-Logik feingetuned oder quantisiert werden können.
Für Retrieval-Augmented Generation (RAG) und semantische Suchen sind hochskalierbare Vektordatenbanken wie Qdrant oder Weaviate direkt angebunden. Sie ermöglichen performante Vektor-Ähnlichkeitssuchen in Echtzeit bei minimalem CPU-Overhead.
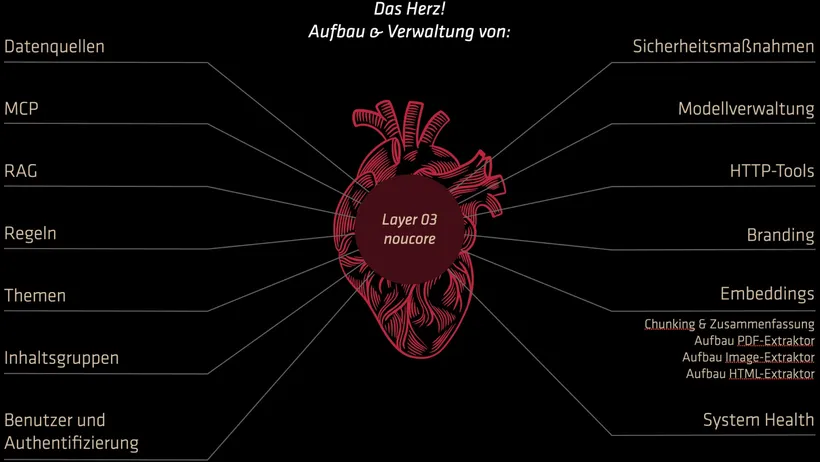
Layer 03 fungiert als die zentrale Steuerungs- und Verwaltungsebene (Orchestrierung). Sie verarbeitet Kernfunktionen in vier Bereichen: Daten & Wissen (RAG, Datenquellen), Steuerung & Logik (Regeln, MCP), Sicherheit & Zugriff (Benutzerverwaltung, Authentifizierung) sowie das gesamte System-Management (Modellverwaltung, System Health).
Die Anwendungsschicht übersetzt die KI-Power über drei dedizierte Schnittstellen in Business-Mehrwerte:
- Chat-Frontend: Eine intuitive Web-UI mit SSO-Integration.
- Tools-Calling: Eine performante Function-calling API für strukturierte JSON-Ausgaben und Systemsteuerungen.
- Workflows: Automatisierte, ereignisgesteuerte Prozessketten, orchestriert über Tools wie n8n.
Durch das Prinzip Security by Design: Da Layer 01 (Hardware) und Layer 02 (Runtime) komplett in Ihrer kontrollierten Umgebung laufen, verlassen zu keinem Zeitpunkt sensible Unternehmensdaten das System für das Modell-Training Dritter. Ein Vendor-Lock-in wird durch konsequenten Einsatz von Open-Source-Standards verhindert.
Dieses Modell bietet maximale Performance in zertifizierten (ISO 27001) Rechenzentren in Deutschland bzw. der EU ohne eigenen Hardware-Wartungsaufwand. Die Datenhaltung ist voll DSGVO-konform, geschützt vor dem US Cloud Act, und die GPU-Server sind exklusiv ohne Multi-Tenancy für Sie reserviert.
Dieses Modell eignet sich für kritische Infrastrukturen (KRITIS), höchste Geheimhaltungsstufen oder ultra-niedrige In-House-Latenzen. Der gesamte Stack kann komplett autark und ohne externe Internetverbindung (Air-Gapped) im eigenen Rechenzentrum betrieben werden, sodass die absolute Datenhoheit physisch im Firmennetzwerk verbleibt.
Kontakt
- Schnelle Antwort
- Persönliches Feedback statt Standardmails
- Klare, offene Kommunikation
Beschreiben Sie uns kurz, wobei wir helfen können.
Wir freuen uns auf Ihre Nachricht!